Cada tanto alguien publica su lista de herramientas y la mitad de los comentarios son «yo uso otra». La discusión de la lista es la menos interesante: dos desarrolladores con listas casi opuestas pueden trabajar igual de bien, y dos con la misma lista pueden tener días radicalmente distintos.
Lo que sí diferencia es qué problemas ya no aparecen. Mi stack de trabajo es Java con Spring Boot en el backend, Angular en el frontend y Kubernetes en el despliegue. Alrededor de ese núcleo, lo que construí no es una colección de herramientas favoritas: es un conjunto de decisiones que eliminaron categorías enteras de fricción.
Si tú no programas pero pagas por software, este artículo te sirve igual: al final hay seis preguntas concretas para saber si quien te está construyendo el sistema ya tiene esto resuelto o te lo va a cobrar más adelante en forma de retrasos.
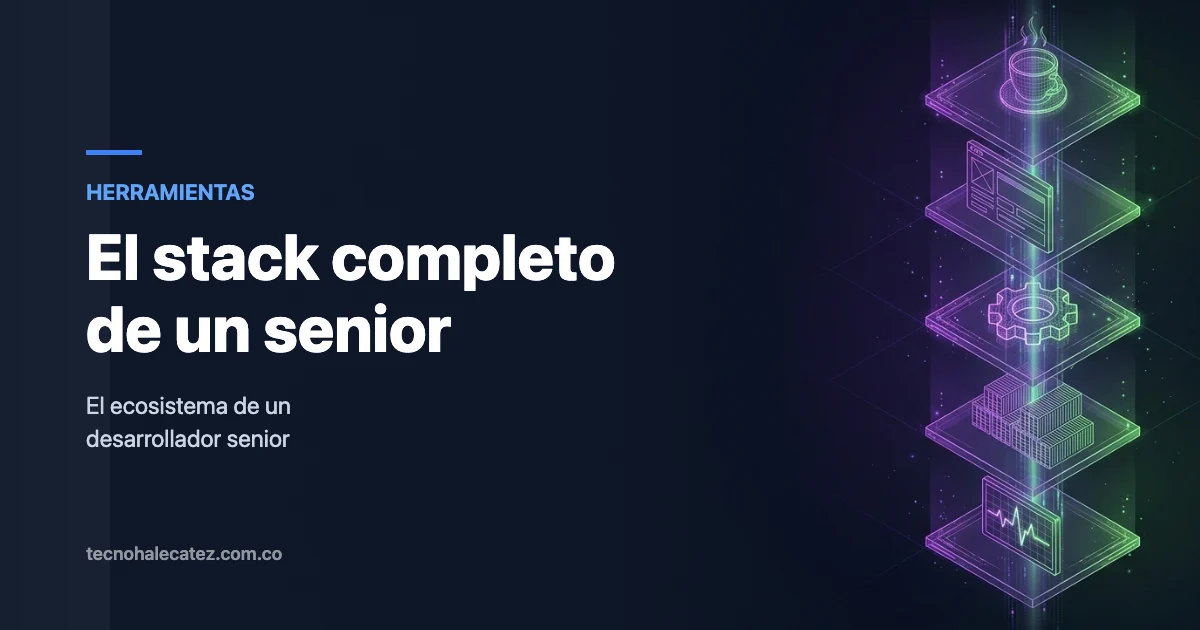
Las cinco capas
La observación incómoda es que la mayoría de las discusiones de herramientas ocurren en la capa 1 —qué framework, qué lenguaje— que es justamente la que menos margen de mejora tiene una vez está decidida. Las capas 2, 3 y 5 son donde vive la diferencia entre un día productivo y uno perdido.
Capa 2: el entorno local debe parecerse a producción
El «en mi máquina funciona» no es un chiste: es el síntoma de una capa 2 rota. Y en un stack con Java, Node y Kubernetes hay tres fuentes de divergencia clásicas.
- Versión del JDK y de Node. Fíjalas en el repositorio, no en la cabeza de cada quien. Gestores como SDKMAN para Java o nvm/fnm para Node, con el archivo de versión versionado, resuelven el problema de raíz: el que clona el proyecto obtiene la versión correcta sin preguntar.
- Dependencias de infraestructura. Base de datos, cache, broker de mensajes. Un
docker composeen la raíz del repositorio que levante exactamente lo que el proyecto necesita, con las mismas versiones mayores que producción. Nadie debería instalar PostgreSQL en su máquina. - El arranque. Un comando. Si arrancar el proyecto requiere leer un documento de siete pasos, ese documento va a quedar desactualizado y alguien va a perder una mañana.
La prueba de fuegoMáquina nueva, repositorio recién clonado, cero conocimiento previo: ¿en cuánto tiempo está el proyecto corriendo? Si la respuesta pasa de media hora, la capa 2 tiene deuda. Es el mejor indicador que conozco de la salud de un proyecto, y el que más se descuida porque el equipo actual ya no lo sufre.
Los contenedores de desarrollo —definir el entorno completo en un archivo que el editor levanta— resuelven esto de forma bastante definitiva, a costa de algo de rendimiento y de una curva inicial. Vale la pena en equipos de más de tres personas o en proyectos que se retoman después de meses.
Capa 3: el ciclo de feedback es el verdadero multiplicador
Aquí está la ganancia real, y se mide en segundos. El tiempo entre guardar un cambio y ver si funcionó define cuántas veces al día puedes experimentar. Si ese ciclo dura noventa segundos, dejas de probar hipótesis y empiezas a razonar a ciegas para no pagar el costo.
| Qué | Objetivo | Cómo se consigue |
|---|---|---|
| Cambio en backend | Segundos | Recarga en caliente de Spring Boot; evitar reinicios completos |
| Cambio en frontend | Inmediato | Servidor de desarrollo de Angular con recarga en el navegador |
| Prueba unitaria | Menos de 10 s | Sin contexto de Spring completo; instanciar la clase directamente |
| Prueba de integración | Menos de 1 min | Contenedores efímeros contra la base real, no contra una en memoria |
| Suite completa | Minutos, en CI | No en tu máquina, no en cada guardado |
Dos decisiones concretas que rinden más que cualquier otra en esta capa:
Probar contra la base de datos real, en contenedor efímero. Las bases en memoria mienten: aceptan SQL que el motor real rechaza y esconden diferencias de tipos, de transacciones y de índices. Levantar el motor real en un contenedor que vive lo que dura la prueba cuesta unos segundos más y elimina una clase entera de bugs que hoy descubres en el ambiente de pruebas.
Migraciones de esquema versionadas desde el día uno. El esquema es código. Herramientas como Flyway o Liquibase convierten el «¿y cómo queda la base en el otro ambiente?» en un no-problema. Dejar que el ORM genere el esquema automáticamente está bien para un prototipo de una semana y es una trampa en todo lo demás.
Sobre el IDEIntelliJ IDEA o VS Code es una discusión sin ganador y sin consecuencias. Lo que sí tiene consecuencias es que el formato de código, el linter y las reglas estén en el repositorio y no en la configuración personal de cada quien. Un proyecto donde el formateo depende del editor genera diffs llenos de ruido y revisiones de código que discuten espacios.
Capa 4: del commit al clúster
Con Kubernetes de por medio, la regla que ordena todo es simple: el estado deseado vive en un repositorio, no en la memoria de quien despliega. Nada de kubectl apply desde el portátil de alguien.
- Una imagen por commit, etiquetada con el hash, construida en CI y nunca en una máquina local. Imágenes base delgadas y construcción en múltiples etapas para no cargar el JDK completo al runtime.
- Manifiestos versionados con Helm o Kustomize. La diferencia entre ambientes debe ser un archivo de valores, no un manifiesto distinto.
- Despliegue desde el repositorio, idealmente con un agente que reconcilia el clúster contra Git. Así el clúster nunca tiene cambios que nadie registró, que es el origen del «esto funcionaba y no sé qué pasó».
- Salud declarada de verdad. Spring Boot Actuator expone los probes que Kubernetes necesita; configurarlos bien es la diferencia entre un despliegue sin interrupción y uno que tumba tráfico.
El error más caro del stackKubernetes no es una capa 2. Correr un clúster local para desarrollar día a día es pagar un costo diario enorme para simular un problema que casi nunca es el tuyo. Desarrolla contra docker compose; deja el clúster para el ambiente de pruebas en adelante. Y si el proyecto no necesita escalar ni tiene varios servicios, revisa con honestidad si necesita Kubernetes: mucha de la complejidad que vemos en proyectos medianos es infraestructura comprada por adelantado para un crecimiento que no llegó.
Capa 5: observar en vez de adivinar
Esta es la capa que más separa a un senior de alguien con menos recorrido, y no porque sea difícil: porque se monta antes de necesitarla, y eso requiere haber sufrido la alternativa.
- Logs estructurados en JSON, con un identificador de correlación que atraviese toda la petición. Un log de texto plano en un sistema distribuido es un archivo que no puedes consultar.
- Métricas expuestas desde el día uno. Actuator con Micrometer te da latencias, errores y saturación casi gratis. Recolectadas con Prometheus y vistas en Grafana.
- Trazas distribuidas con OpenTelemetry. En cuanto hay más de dos servicios, la pregunta «¿dónde se fueron los 800 ms?» no tiene otra respuesta razonable.
- Alertas sobre síntomas, no sobre causas. Alerta porque subió la latencia del checkout, no porque el uso de CPU pasó del 80 %. Las alertas por causa generan ruido y se terminan ignorando, que es peor que no tenerlas.
El criterio para saber si esta capa está completa: cuando algo falla en producción, ¿abres un tablero o abres una terminal a adivinar? Si es lo segundo, no importa qué tan buena sea tu capa 3.
Lo que no debería estar en tu ecosistema
Tan importante como qué agregar es qué sacar. Las que más he visto costar caro:
- Microservicios sin una razón organizacional. Si un solo equipo mantiene los siete servicios y todos se despliegan juntos, eso es un monolito con latencia de red y problemas de consistencia. Un monolito bien modularizado escala más de lo que la mayoría admite.
- Herramientas que nadie más del equipo entiende. Tu configuración de editor exótica es tuya; la que el proyecto necesita para compilar tiene que ser aburrida y documentada.
- Capas de abstracción preventivas. La interfaz con una sola implementación «por si algún día cambiamos de proveedor» casi nunca se cobra y siempre se paga.
- Asistentes de IA sin revisión. Son un multiplicador real en código repetitivo, pruebas y exploración de APIs desconocidas. También generan código plausible y equivocado con total seguridad. La regla que uso: si no puedo explicar por qué esa línea está ahí, no entra al commit.
La capa que no es software
Dos prácticas que no son herramientas y rinden más que cualquiera de las anteriores.
Registros de decisiones de arquitectura. Un archivo corto en el repositorio por cada decisión relevante: qué se decidió, qué alternativas había y por qué se descartaron. Cuestan diez minutos y evitan la conversación de «¿por qué esto está así?» seis meses después, cuando ya nadie recuerda el contexto y alguien está a punto de deshacer una decisión que era correcta.
Un lugar donde queden las cosas que aprendiste. El comando raro, la configuración que costó dos horas, el porqué de un rodeo en el código. Cualquier herramienta de notas sirve; lo que no sirve es confiar en la memoria o en el historial de la terminal.
Si tú no programas: cómo evaluar a tu proveedor con esto
Todo lo anterior tiene una traducción directa al lenguaje de quien paga la factura: un proveedor con estas capas resueltas entrega más rápido y cobra menos mantenimiento; uno sin ellas cobra barato al principio y caro para siempre. No necesitas entender la tecnología para verificarlo. Necesitas seis preguntas.
| Pregúntale | Buena señal | Mala señal |
|---|---|---|
| Si contrato otro desarrollador mañana, ¿en cuánto tiempo puede empezar? | Horas: el proyecto arranca con un comando | «Le explicamos y en una semana está listo» |
| ¿Cómo saben si un cambio rompió algo? | Pruebas automáticas que corren solas en cada cambio | «Lo probamos antes de subir» |
| ¿Quién puede desplegar a producción y desde dónde? | Un proceso automático desde el repositorio | Una persona, desde su propio computador |
| Si el sistema se pone lento un martes, ¿cómo lo averiguan? | Tableros con métricas y alertas ya montadas | «Revisamos los logs del servidor» |
| ¿El código y las cuentas de nube quedan a nombre de mi empresa? | Sí, y te entregan los accesos | Todo vive en las cuentas del proveedor |
| ¿Por qué eligieron esta arquitectura? | Una razón concreta ligada a tu operación | «Es lo que se usa hoy», o una lista de tecnologías de moda |
La pregunta que más ahorraLa quinta. Un sistema cuyo código y cuyas cuentas de nube están a nombre del proveedor no es tuyo: es un alquiler en el que no tienes con qué negociar. He visto empresas pagar dos veces el mismo desarrollo por no haberlo preguntado en la primera reunión. Eso va en el contrato, no en la conversación.
Ninguna de las seis exige que sepas de tecnología. Las respuestas sí te dicen, en cinco minutos, si estás contratando a alguien que ya resolvió estos problemas o a alguien que los va a descubrir con tu presupuesto.
Herramientas gratis para esto
- Formatear JSON: valida y explora una respuesta de API sin abrir el IDE.
- Decodificar JWT: mira la cabecera, el contenido y la expiración de un token. Usa tokens de prueba, nunca uno de producción.
- Probador de expresiones regulares: prueba el patrón antes de meterlo al código.
- Convertir timestamp: traduce el epoch de un log a una fecha legible.
- Generador de UUID: identificadores para datos de prueba.
Preguntas frecuentes
¿Por dónde empiezo si mi proyecto no tiene nada de esto?
Por la capa 2, siempre. Que el proyecto arranque en un comando en una máquina nueva es lo que habilita todo lo demás y lo que paga más rápido. La observabilidad es la segunda, aunque se sienta menos urgente.
¿Esto aplica si soy el único desarrollador?
Casi todo. Las capas 2, 3 y 5 te sirven igual, porque tu yo de dentro de seis meses es, para efectos prácticos, otra persona que no recuerda nada. Lo que puedes simplificar es la capa 4: un flujo de despliegue sencillo y reproducible basta.
¿No es mucha herramienta para un proyecto pequeño?
Sí, si lo tomas como una lista para instalar completa. No es eso: es un conjunto de criterios. En un proyecto pequeño, la capa 2 puede ser un docker compose de veinte líneas y la capa 5 puede ser logs estructurados y nada más. Lo que no cambia con el tamaño son los criterios.
Mi proveedor dice que todo esto es sobreingeniería. ¿Tiene razón?
A veces sí, y conviene escucharlo: un proyecto de dos meses no necesita trazas distribuidas ni Kubernetes. Pero hay un piso que no es negociable en ningún tamaño: que el proyecto arranque en una máquina nueva sin drama, que existan pruebas automáticas y que el despliegue no dependa del computador de una persona. Si a eso le llaman sobreingeniería, no están hablando de complejidad: están hablando de no hacerlo.
¿Cada cuánto conviene revisar el stack?
Cuando algo duele, no en calendario. Cambiar de herramienta porque salió una nueva tiene un costo de aprendizaje que rara vez se recupera. La excepción son las versiones de seguridad y las versiones con soporte extendido del lenguaje: esas sí se siguen por calendario.
La conclusión, sin rodeos
El mejor ecosistema no es el que tiene las herramientas más nuevas: es el que te deja pasar el día pensando en el problema del negocio y no en el entorno. Si tu semana se va en pelear con configuraciones, versiones y despliegues, el problema no es que te falte una herramienta. Es que te sobran.
Y si tuviera que quedarme con una sola frase: el entorno local que se parece a producción es la inversión que más veces se paga sola.
¿Estás pagando por un software y no sabes si está bien construido?
Reviso cómo está montado tu proyecto —arranque, pruebas, despliegue y monitoreo— y te digo en lenguaje claro qué está bien, qué te va a costar caro más adelante y qué preguntarle a tu proveedor. Respondo personalmente.
Hablemos de tu proyecto